它盯着媒体库,甄别每一条候选字幕,装好最合适的那个。
自托管字幕自动化,支持多种语言,中文源覆盖最强。
AGPL-3.0 · 一个 Docker 容器 · 密钥只在你自己的服务器上
搜什么,查什么
五个字幕源
- ASSRT中文字幕库,密钥免费申请。
- SubHD中文社区字幕站,无需密钥。
- Zimuku中文字幕索引站,无需密钥。
- OpenSubtitles105 种语言的通用覆盖。
- Jimaku日文专项源。
SubHD 与 Zimuku 免密钥,默认关闭——需要时在设置里打开。
身份核验与时间轴校验
每一条候选字幕在安装前都会对照实际视频校验——作品和集数对不对,时间轴合不合。不过关的候选不会碰你的媒体库。
能力
TMDB 识别
文件名靠不住。搜索之前,先通过 TMDB 把每个文件对上真正的作品——对的电影、对的季、对的集。
能力
LLM 翻译
找不到能用的目标语言字幕?翻译通道可以用你自己的 LLM 密钥,从日文或英文源翻出一份。
不依赖媒体服务器
直接扫描目录,把字幕写到视频文件旁边。Jellyfin、Emby、Plex 都能直接识别——但一个都不需要。
语言覆盖,说实话
- 中文——覆盖最厚:三个专属源。
- 日文——有专属源(Jimaku)。
- 其余八种可选语言(英/韩/西/法/德/葡/俄/意)——管线内同等正式支持,字幕检索走 OpenSubtitles 的 105 种语言覆盖。
非中文源目前还比较少。想让你的语言覆盖更好,provider adapter 是一个边界清晰的贡献点:一个接口四个成员——name、enabled、search、resolve,一屏装得下。
一条字幕是怎么装上的
发现
直接扫描媒体目录——不依赖 Jellyfin、Emby 或 Plex——找出所有缺目标语言字幕的作品。
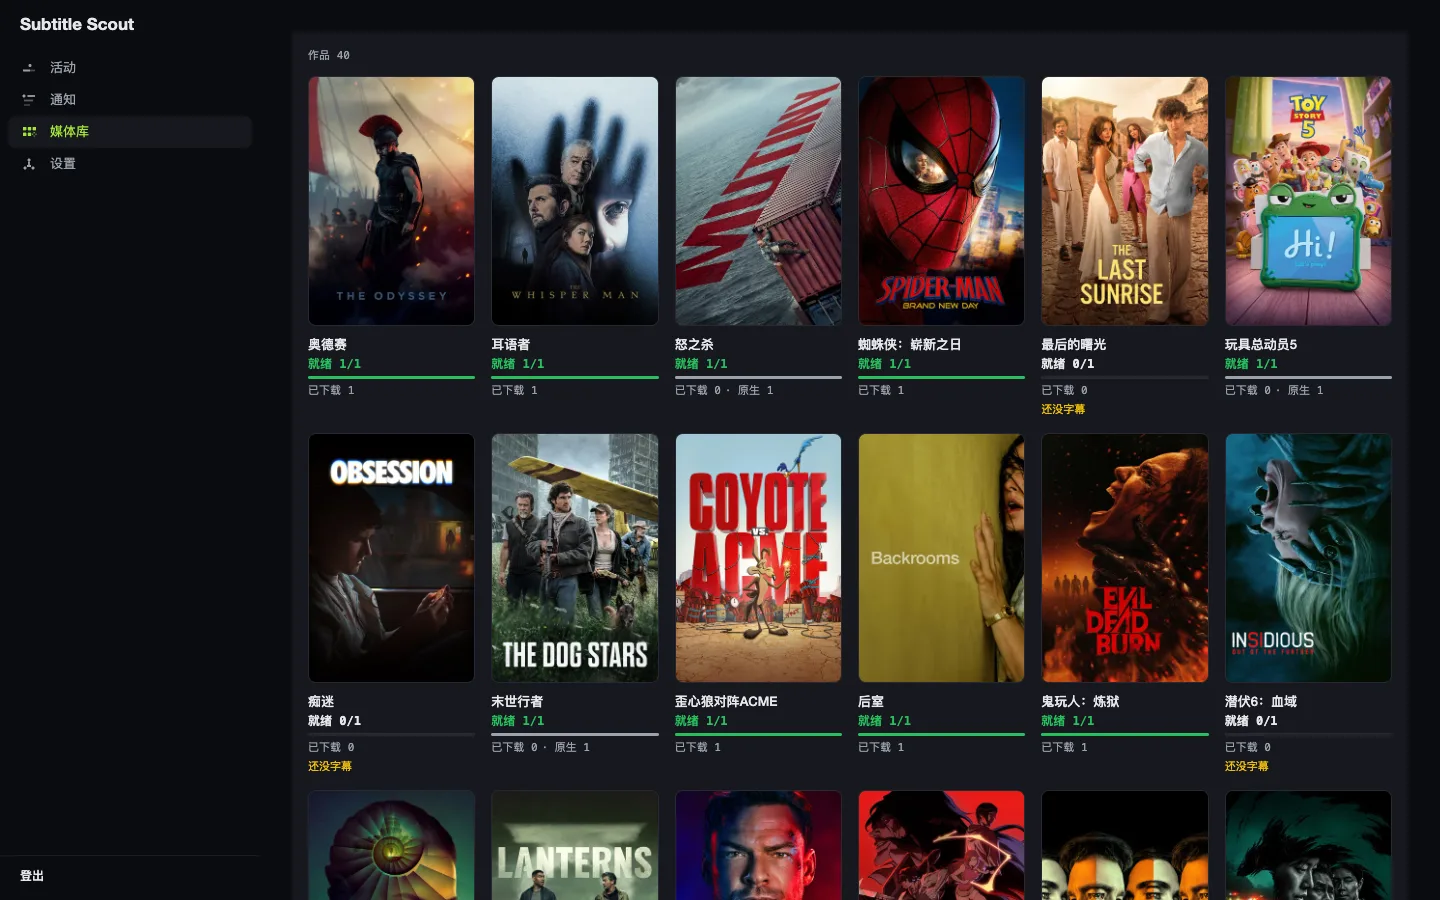
判断
搜索五个字幕源,对照实际视频做身份与时间轴校验,给候选排序后才选定一条。
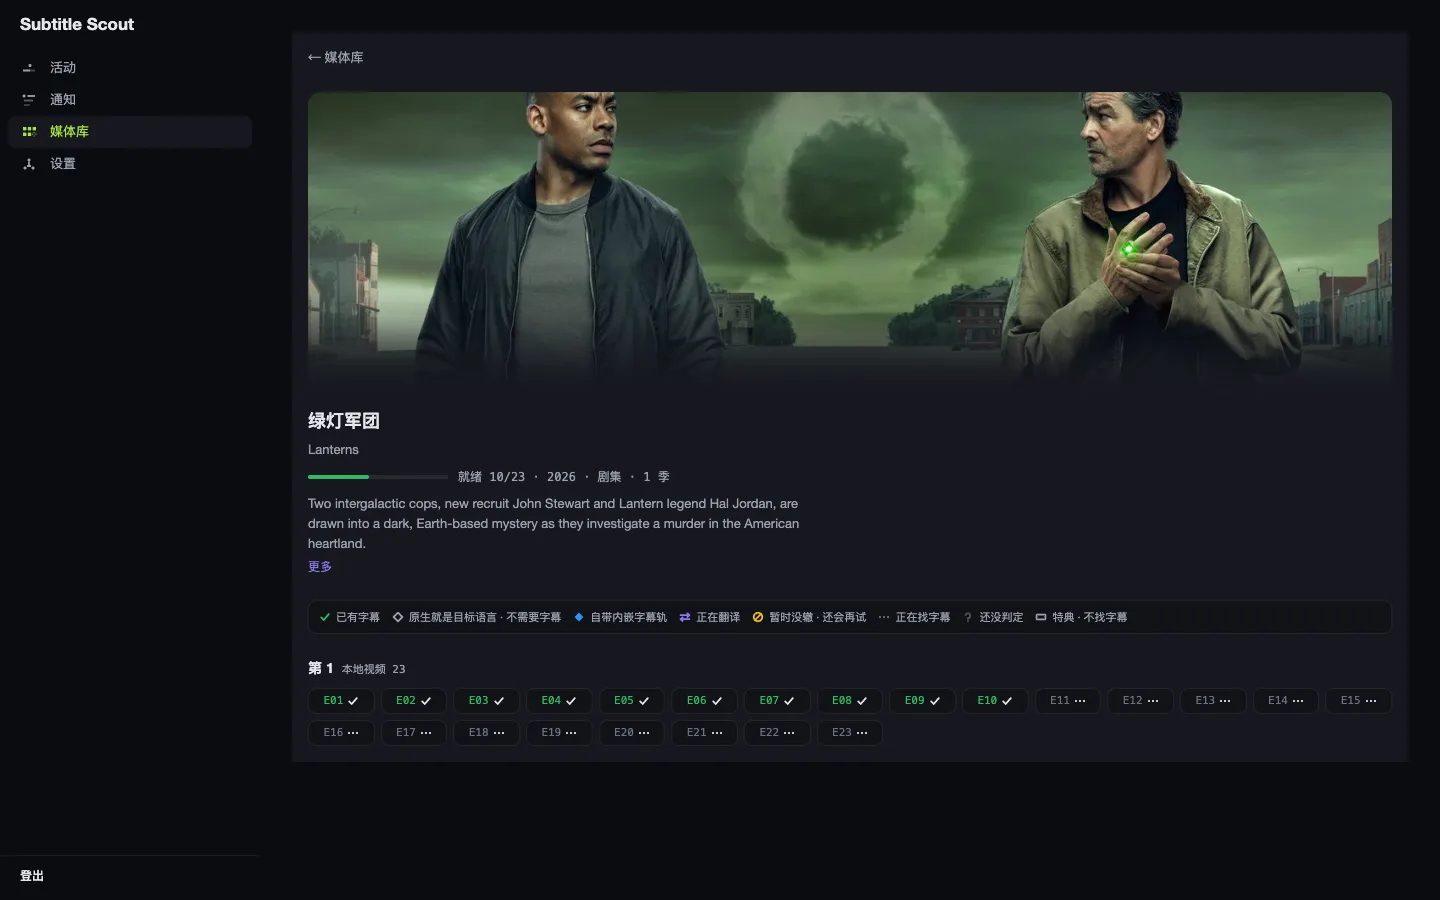
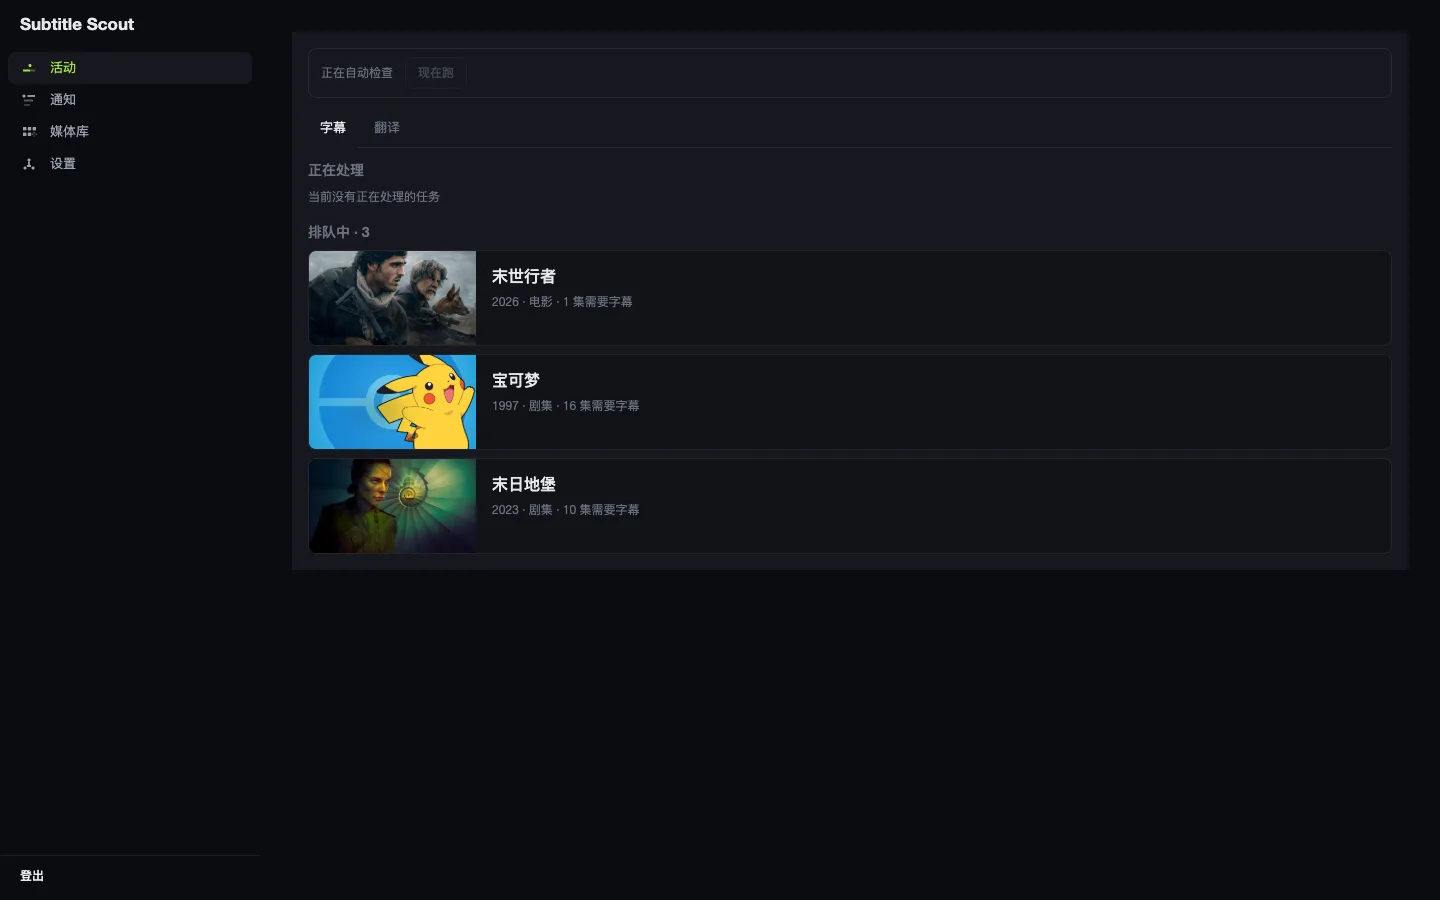
装好
选中的字幕直接写到视频文件旁边,按播放器都能识别的方式命名。实在找不到能用的源,还有 LLM 翻译通道兜底。
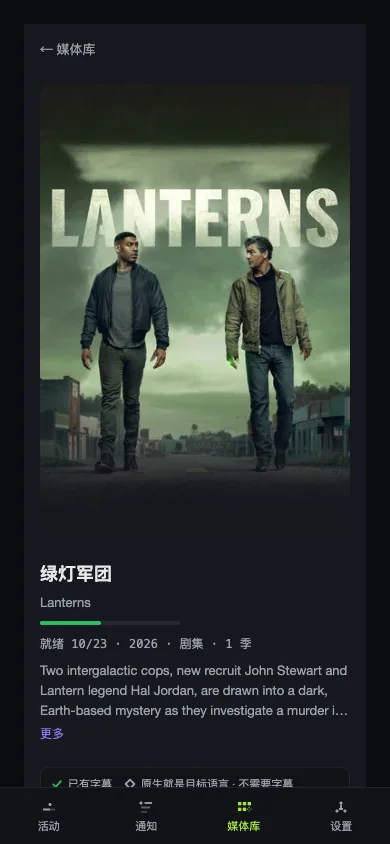
手机上是完整面板,底部标签直达每一页。
一条命令跑起来。
任何能跑 Docker 的地方都能用——NAS、家庭服务器或 VPS。启动后在设置向导里配置 TMDB、ASSRT 与大模型;密钥不需要写进 compose 文件。
# docker-compose.yml
services:
  subtitle-scout:
    image: ghcr.io/fancydirty/subtitle-scout:latest
    restart: unless-stopped
    ports:
      - "8099:8099"
    volumes:
      - /:/hostroot      # 挂载宿主机根目录,方便在监控页选择媒体目录
      - ./cache:/cache
    environment:
      TZ: Asia/Shanghai

# 然后
cp .env.example .env
docker compose up -d
国内网络访问 ghcr.io 较慢或不通时,把镜像地址前缀换成国内镜像源:
image: ghcr.1ms.run/fancydirty/subtitle-scout:latest装之前想知道的
- 需要自己申请 API 密钥吗?
- 需要。TMDB 必填且免费;要用中文覆盖,强烈建议再配一个同样免费的 ASSRT 密钥。密钥由你自己申请、自己掌控,用量不经过任何第三方中转。
- 只支持中文字幕吗?
- 不是。中文覆盖最厚——有三个专属源——日文也有专属源,英文和韩文正式支持,其余 OpenSubtitles 覆盖的语言都能用。缺口还可以用翻译通道补上。
- 需要 Jellyfin、Emby 或 Plex 吗?
- 不需要。Subtitle Scout 直接扫描文件系统,把字幕文件放到视频旁边,播放器会自动识别。
- 开源协议是什么?
- AGPL-3.0。而且它是自托管的:你的媒体库、密钥和观看记录都不会离开你自己的服务器。